k3s + Cilium + Tailscale 双栈网络改造:评估、实验与生产落地
本文最后更新于:2026年10月16日 上午
前言
终于等来了国庆长假!宅在家折腾自己的 HomeLab、 K8s、 NAS 服务器集群的感觉真爽!这次长假真的是折腾了好多东西,感兴趣的读者请期待后续的爆更,等不及的话也可以直接看我的 repo - east4ming/homelab2 的 PR 和 Commits。
这应该是 2026 国庆系列的最后一篇了。
起因很朴素:家里那套 homelab k3s 集群跑了两年多,一直是 IPv4-only。运营商给了 /56 的 IPv6 前缀,路由器上静态路由也配好了,集群内部就是不动。每次从外面 curl -6 打进来,都得在前面挂一层 NAT 转换,越看越别扭。
IPv6 是大势所趋,于是决定把整个集群改成 IPv4 / IPv6 双栈。
然后我就发现,这事儿比想象中麻烦得多。k3s 官方文档对 "既有 IPv4-only 集群原地开启双栈" 这件事,基本是不背书的。注意,不是 "不支持",是 "我们不保证",这两者差别很大。
所以这篇文章不是一份成功学教程,而是一次 "从不确定到确定" 的过程记录:怎么用本地同版本实验把未知风险变成可量化的确定性行为,怎么在生产上踩坑再爬出来,以及最后那些跟网络协议本身没关系的坑。
📝声明:本文基于我自己的 homelab 生产集群(4 节点),不是玩具环境。但 homelab 终究是 homelab,请勿直接照搬到贵司核心生产集群,风险自担。
⚠️风险提示
k3s:不支持在既有集群上原地开启双栈
https://docs.k3s.io/networking/basic-network-options(Dual-stack 小节)原文:
Dual-stack networking must be configured when the cluster is first created.
It cannot be enabled on an existing cluster once it has been started as IPv4-only.
Cilium 1.20 侧同样没有 "单栈→双栈" 迁移文档
搜索 Cilium docs:
只有 4 个文件提到 dual-stack(BGP×2、LB IPAM、ENI),没有任何双栈指南或迁移页。
唯一的在线 IPAM 迁移是 cluster-pool → multi-pool,且明确 “In case of failure, no rollback is available.”
→ 与 k3s 的禁令叠加,
结论:原地双栈无任何厂商文档背书,只能按 "需自证" 处理。
最终效果展示
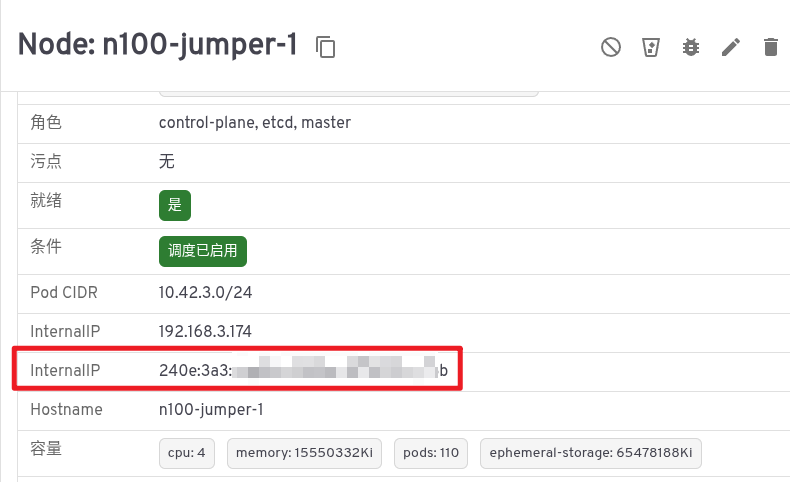
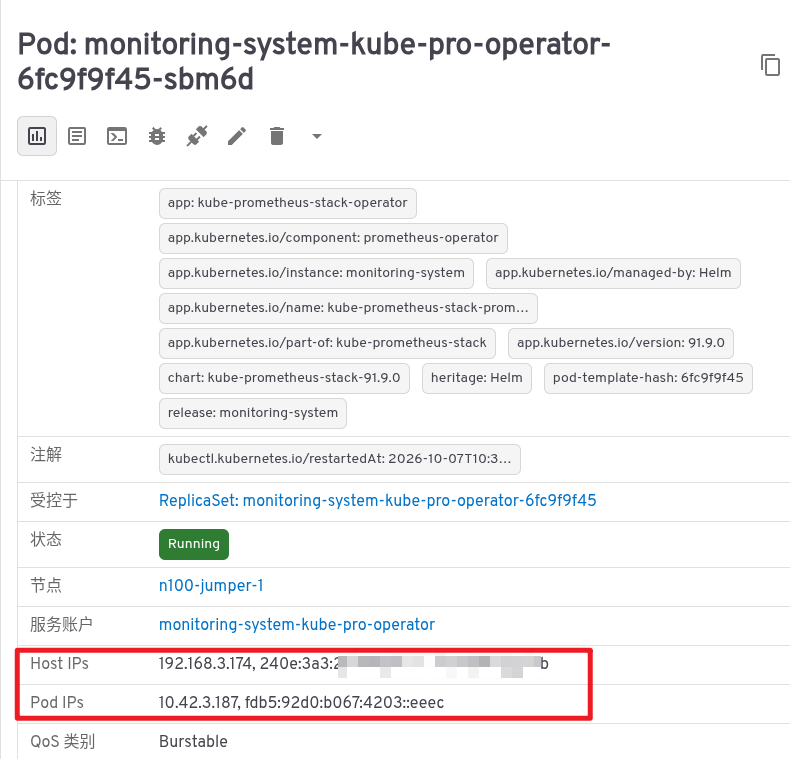
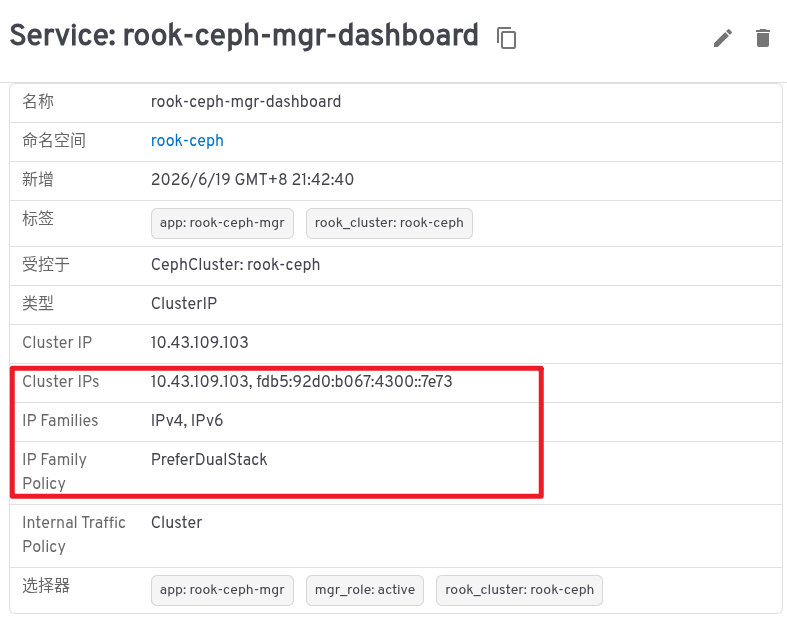
背景:集群长什么样
先交代环境,不然后面的坑说不清楚:
| 组件 | 版本 / 配置 |
|---|---|
| k3s | v1.36.5 + k3s1,4 节点(3 server + 1 agent 混合) |
| CNI | Cilium 1.20.2,原 ipam.mode=kubernetes |
| Service 网络 | 10.43.0.0/16 |
| Pod 网络 | 10.42.0.0/16 |
| 其他 | Tailscale Operator v1.102.4、Rook-Ceph、ArgoCD |
| 控制面 | disable-cloud-controller: true |
改造前评估了三条路线:
- 路线 A:控制面 + Pod + Service 全面双栈(官方不背书)
- 路线 B:只在节点和 tailnet 层面双栈
- 路线 C:仅做节点 + tailnet 双栈,集群内部保持 IPv4
一开始我选的其实是 C,因为 "官方不背书" 这五个字太沉了。但后来想想,不做 Pod / Service 双栈,等于白折腾一半 —— 容器里还是 IPv4-only,那 IPv6 的意义在哪?
于是回到路线 A,但拆成了 A′:P1 先让控制面双栈,P2 再让 Cilium 分配 IPv6 PodCIDR。分两步走,每步都能独立回退。
第一步:官方说不行,那就自己实验
最大的未知风险只有一个:apiserver 的 --service-cluster-ip-range 从 IPv4-only 改成双栈,它会拒绝启动吗?还是会带着旧 Service 继续跑?
这个问题没人给答案,因为没人愿意拿生产集群试。那我就在本地 Docker 里,起一个和生产完全相同版本的 k3s,先把 IPv4-only 集群建起来,再改 flag 重启,做对照实验。E1 到 E14,一共十四轮。
结论比我预期的要好:
- 三个 flag 必须一起改:
cluster-cidr、service-cidr、node-ip。IPv4 在前,逗号后不能有空格。少改一个,或者顺序反了,apiserver 直接 fail-fast。 - 失败模式是确定性的。不是把 etcd 写坏,不是半死不活,是启动时就报错退出。这个性质很重要,意味着失败可恢复。
- 成功时约 15 秒完成启动。
- 既有 Service 的爆炸半径实测只有一个对象:kube-dns。因为 k3s 会自动派生第二个 cluster-dns,并把它置为
RequireDualStack。
第 3 条和第 4 条是让我敢动手的关键。如果爆炸半径是 "所有 Service 全部重建",那这活儿我就不干了。
📝Notes:这里有个反直觉的点 —— 很多人以为改 ServiceCIDR 会让所有 ClusterIP 重新分配。实测不是。既有 Service 的
ipFamilyPolicy会被置回SingleStack,ClusterIP 保持不变。双栈是 opt-in 的,不是全局开关。
第二步:Cilium IPAM 才是真正的深坑
控制面双栈只是开胃菜,Pod 双栈才是主菜。
我最初想当然的方案是:给 Node 打个注解 network.cilium.io/ipv6-pod-cidr,让 Cilium 补一个 IPv6 PodCIDR 不就完了?
实测证伪。在 Cilium 1.20.2 下这个注解根本不生效。
那能不能直接改 Node.spec.podCIDRs?不能,这个字段不可修改。那把控制面 Node 删掉重建,让 k3s 重新分配?也不行,被 k3s 的 finalizer 阻塞了。
所以结论很硬:在 ipam.mode=kubernetes 下,Pod 双栈走不通。因为 Cilium 要求每个启用的地址族都必须有 PodCIDR,缺一个,agent 直接 panic + CrashLoopBackOff,全集群 Pod 网络中断,这可不是闹着玩的。
唯一的路是切到 Cilium 自己的 IPAM:
1 | |
关键点:ipam.mode 切换和 ipv6.enabled=true 必须在同一次 helm upgrade 内完成。分两次做,中间那个状态就是 agent 全挂。
陈旧 CiliumNode 的静默阻塞
切完之后,新问题来了:DS 停在 2 / 4,新起来的 agent 报 required IPv6 PodCIDR not available。
原因是节点上残留的 CiliumNode.spec.ipam.podCIDRs 里只有 IPv4,operator 一看 ——“这节点已经分配过了”,就静默跳过,IPv6 PodCIDR 永远补不上。
解决办法是手工 patch:
1 | |
注意保留原 IPv4 映射,否则路由器上的静态路由全得改,工作负载还得重建一遍。这个坑值得单独拎出来说:operator 的 "已分配" 判断是静默的,不报错、不告警,只是不动。
第三步:那些跟网络协议没关系的坑
到这一步,协议层面的问题基本解决了。但生产执行真正卡住我的,是下面这些。
坑 1:Node 没有 IPv6 InternalIP
因为集群 disable-cloud-controller: true,k3s 在 node-ip 为双栈时刻意不把它传给 kubelet。结果就是 Node 的 InternalIP 仍然只有 IPv4。
得显式补:
1 | |
还有个验证的坑:kubectl get nodes -o wide 只渲染一个 InternalIP,看着像没生效。
示例效果如下:
1 | |
得用:
1 | |
坑 2:operator 会抹掉 restartedAt 注解
已创建的 Pod 不会被 Cilium 改写为双栈,必须重建。常规做法是 kubectl rollout restart。但对被 operator 托管的 workload(KubeVirt、Tailscale ProxyGroup 这类),operator 会把 restartedAt 注解抹掉,restart 直接无效。
改用直接删 Pod,让控制器按当前模板重建:
1 | |
坑 3:GitOps 客户端必须先双栈化
这个是交付链耦合问题,很隐蔽。ArgoCD 的 repoURL 指向 gitea 的 ClusterIP。如果你先把 gitea-http 这个 Service 改成 PreferDualStack,而 ArgoCD 的 Pod 还是 IPv4-only,DNS 同时返回 A 和 AAAA,客户端优先解析到 AAAA,然后 ENETUNREACH,git clone 直接失败。
顺序不能反:先双栈化客户端 Pod,再改对应的 Service。
📝Notes:Service 双栈是 opt-in 的。开启双栈后,新建 Service 默认仍是 SingleStack,IPv6 ClusterIP 只出现在显式声明
PreferDualStack或RequireDualStack的 Service 上。转换用kubectl patch即可,原 IPv4 ClusterIP 完整保留,不用重建。
最终状态与回退方案
改造完成后的实际数据:
| 指标 | 结果 |
|---|---|
| Pod 双栈 | 168 / 168(集群内无 IPv4-only Pod) |
| 有 IPv6 ClusterIP 的 Service | 29 个(28 个批量转换 + 1 个先前试点) |
| 节点 InternalIP | 4 台均为 IPv4 + IPv6 |
| Cilium DS | 4/4 |
| Ceph | HEALTH_OK(22.20k objects / 81 GiB / 81 pgs active+clean / 4 OSD up/in) |
| PVC | 50/50 Bound |
| ArgoCD | 36/36 Synced |
这次改动风险很大,必须做好完全准备:
- 备份!备份!还是备份!
- 万无一失的回滚方案
未完成的事项
诚实地说,还有几件事没做干净:
- 有 7 个 Service 无法在 Git 仓库里声明,只能靠幂等 patch 补救
- metrics-server 没有追溯补发 IPv6 ClusterIP
- 部分
ipFamilyPolicy是回写仓库的,不是仓库驱动的,存在配置漂移风险
这些都不影响当前运行,但属于技术债,得记着。
总结
回头看,这次改造最值钱的部分不是 "双栈怎么配",而是把厂商不背书的模糊地带,用同版本对照实验压成了确定性的行为。官方文档说 "不保证",实验说 "会 fail-fast,不损坏 etcd,爆炸半径是 1 个对象"—— 这两句话的信息量天差地别。前者让你不敢动,后者让你知道怎么动、怎么退。
至于那些非网络的坑(operator 抹注解、GitOps 链路耦合),本质上都指向同一件事:大规模网络改造的成败,往往不在网络本身,而在你对控制面启动顺序、控制器行为和交付链耦合的精细把握。
历史车流滚滚向前。IPv6 这东西,来得慢,但拦不住,那就主动去接纳。
以上。
